Qwen3.8-Flash-Next:DGX Spark 2台の各2・4並列とTP=2実測
CHATGPT / AIChatGPTなどの生成AIを活用して運営・記事制作・更新を行っています。制作方針
広告この記事には広告・アフィリエイトリンクが含まれます。表示・選定方針
ASUS GX10を2台使い、Qwen3.8-Flash-Nextの各台2・4並列とTP=2を実測。4K/32K入力での全体出力速度、TTFT、利用可能メモリを比較し、測定CSVと図を公開します。

測定日:2026年9月5日。NVIDIA GB10を搭載したASUS GX10を2台使い、Qwen3.8-Flash-Nextの並列推論を比較した。
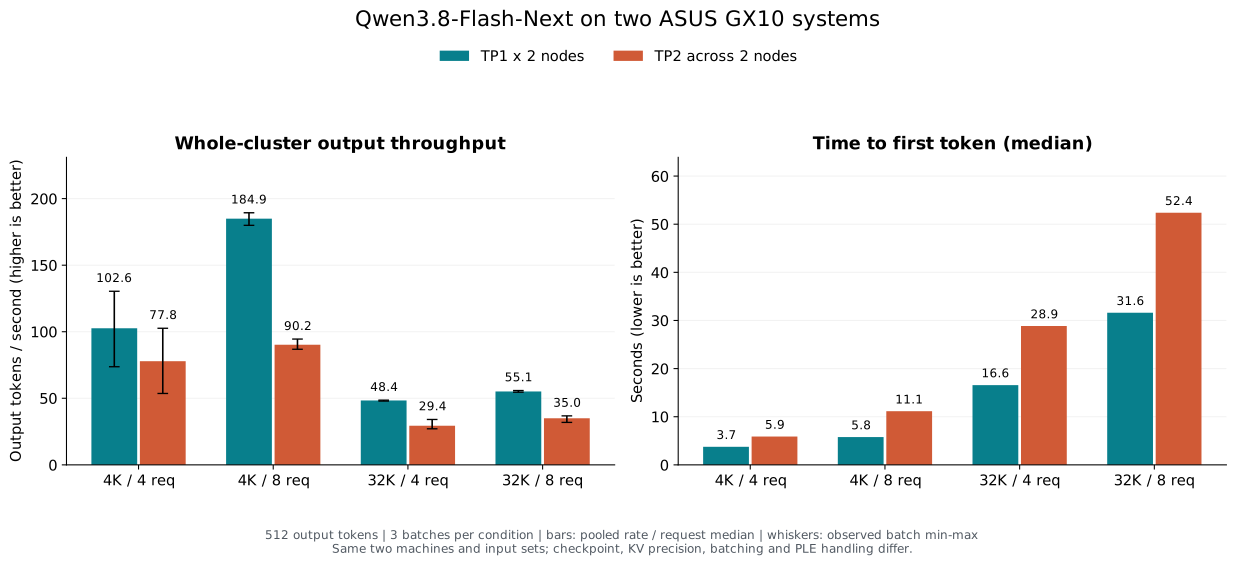
今回の総4・8要求では、独立したTP=1を2台で動かす方が全体出力速度は高かった。 合計8要求では、4K入力が184.9対90.2 tok/s、32K入力が55.1対35.0 tok/s。応答開始を優先するなら各台2並列、処理量を優先するなら各台4並列、という違いも見えた。
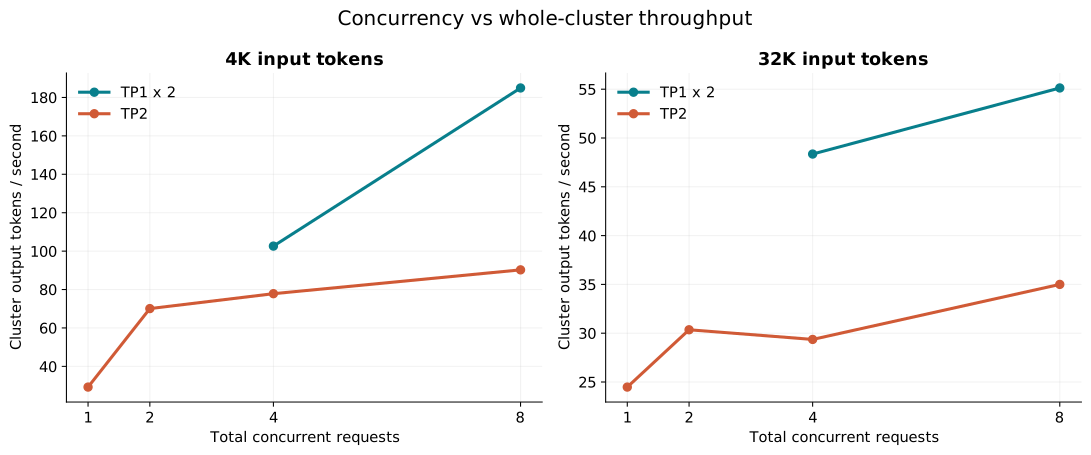
比較したのは、各台にモデルを1つずつ載せて別々の要求を処理する「TP=1 × 2台」と、2台で1つのモデルを分担する「TP=2」だ。独立構成では各台2並列・合計4並列と、各台4並列・合計8並列を試した。TP=2では、2台全体で1・2・4・8要求を同時に処理した。
用途別の見方
以下の各台2・4並列の使い分けは、今回の独立2台・合計4〜8要求の範囲です。単要求を含むすべての構成で最短の応答時間を選んだ表ではありません。
| 知りたいこと | まず見る条件 | 詳しい結果 |
|---|---|---|
| 応答開始の速さ | 独立構成・各台2並列のTTFT | 独立構成の測定表へ |
| 複数要求の全体処理量 | 独立構成・各台4並列の全体出力 tok/s | 独立構成の測定表へ |
| 一つのモデルを2台で分割したときの性能 | TP=2の要求数別の表 | TP=2の測定表へ |
購入済みなら、まず現在の設定のまま同じ入力長・要求数を測り、表の該当行と比べてください。TP=2へ変えるかは、速度だけでなく、モデルを分割する必要性と自分の要求数で判断します。この測定はTP数だけの比較ではなく、KVキャッシュ精度、PLEの扱い、checkpoint、バッチ設定も異なる実用構成です。回答品質と長時間の安定性は測っていません。
まだGX10/GB10クラスを購入していないなら、先にDGX Spark互換GB10機の比較で候補と購入条件を確認し、その後にこの実測を購入後の並列設定の参考として読んでください。
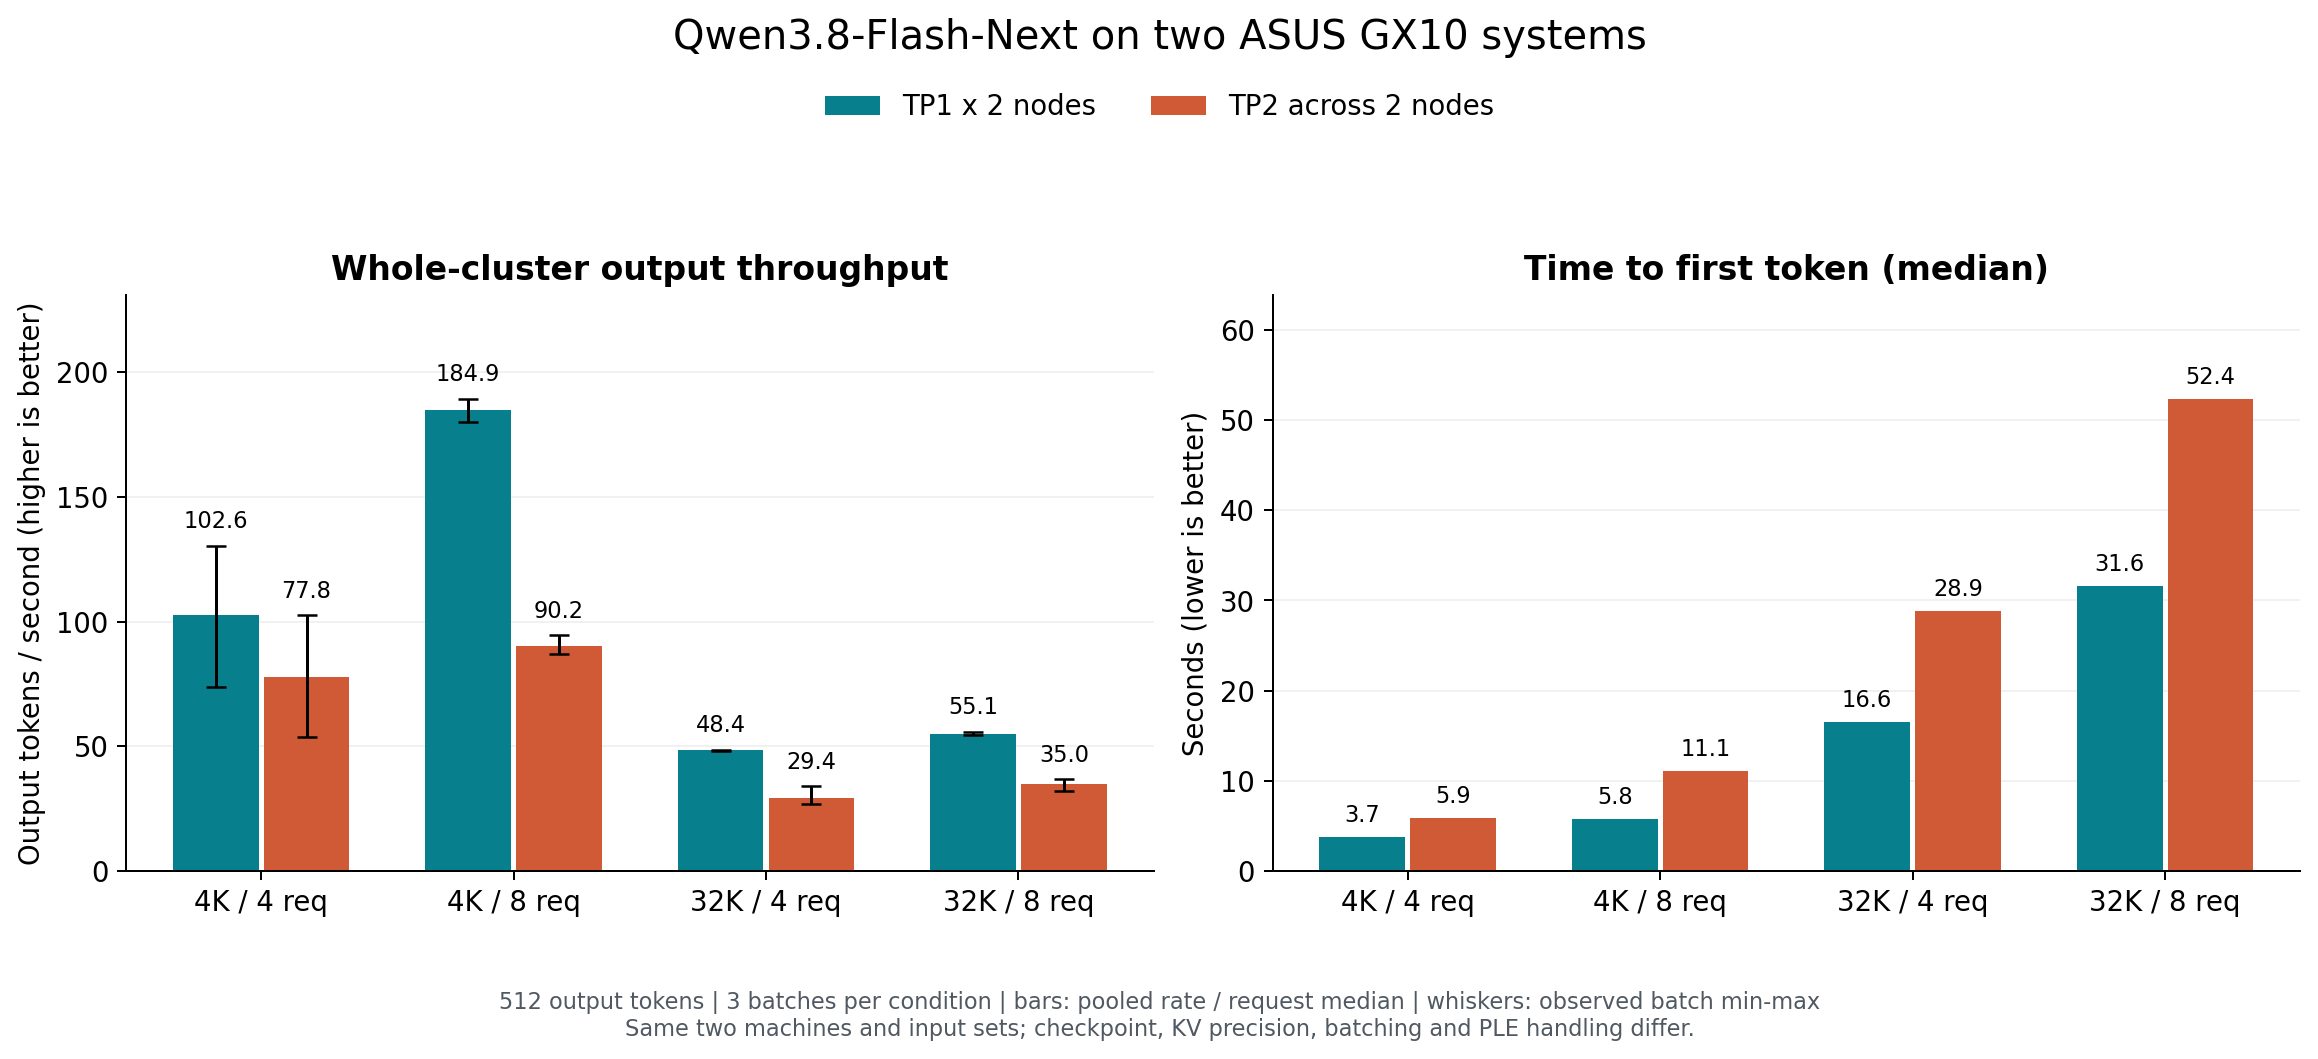
左は全要求が完了するまでの時間から求めた全体出力速度、右は応答が始まるまでの時間のp50(nearest-rank法)。左のひげは3回のバッチで観測した最小〜最大値で、信頼区間ではない。
比較した構成
単体版はMiaAI-LabのSingle DGX Sparkレシピ、TP=2はDual DGX Sparksレシピを基にした、固定済みのローカル構成を使った。
| 項目 | TP=1 × 2台 | TP=2 |
|---|---|---|
| 処理の分担 | 各台に独立したAPI。要求を半数ずつ振り分け | 1つのAPI。2台で1つの要求を分担 |
| 同時要求数 | 各台2または4、合計4または8 | 2台全体で1・2・4・8 |
| サーバーの上限 | 各台4 sequence | 全体8 sequence |
| checkpoint | Mia-AiLab NVFP4版 | RadixArk NVFP4版 |
| model revision | 925d7be6c14c6c9442ef83e8f05b5a3c39304f69 | 7b719225242aacd3dbd3f9407468c2ee9a9d2594 |
| KVキャッシュ | FP8 | auto(BF16) |
| PLE | CPU offloadとmmap | FP8 PLEをGPU側で分割、CPU offload無効 |
| GPU memory utilization | 0.780 | 0.835 |
| max_num_batched_tokens | 2,048 | 8,192 |
| ノード間の推論通信 | なし | CX7 / RoCEの専用直結リンク、EP有効 |
両台ともDGX OS 7.5.0、NVIDIA driver 580.173.02、BIOS GX10DGX.0104.2026.0326.1657。共通条件は、GPUクロック上限2,000MHz、native context 262,144、YaRN無効、MTP 3トークン、同一vLLMコンテナイメージ。各台2並列の試験でも、サーバーの上限は4のままにした。変更したのは投入する要求数である。
イメージは vllm/vllm-openai@sha256:fc120ece0a388cc0aa1caad4a9f1cd92113484ab7ec2fd0efadd62585be05bf8 に固定した。チェックポイントは単体版とRadixArk版で異なる。
これは、同じ2台を使う実用構成の比較だ。TP数の変更による効果だけを測った実験ではない。 KV精度、バッチ設定、PLEの扱い、チェックポイントが異なるため、速度差のすべてをTP=2の効果とは解釈できない。
測定方法と数字の読み方
Macから管理LAN経由で、約4Kまたは32Kトークンの合成入力を送り、各要求で512トークンを出力させた。temperature 0、thinking無効、ignore_eos有効、ストリーミング受信で測った。実際の入力はチャットテンプレートなどの分だけ指定値より長い。正確な範囲は公開CSVに記録した。
各構成・入力長で各APIに1要求のウォームアップを行い、測定は各条件3回。1バッチの全要求を同時に送り、全件完了後に次へ進む。並列数の小さい順・大きい順をラウンドごとに入れ替えた。構成の起動順はTP=1、TP=2で固定している。TP=1は先行の負荷試験を終えた稼働状態から、TP=2はモデル起動後から測った。並列数ごとの追加ウォームアップは行っておらず、熱やコンパイルキャッシュの履歴まで完全に揃えた試験ではない。
要求ごとに先頭付近へ固有のマーカーを置き、バッチ内で同一入力が重複しないようにした。比較対象の総4要求・8要求では、TP=1とTP=2に同じ入力セットを渡し、送信JSONのハッシュを照合した。TP=2だけが同一プロンプトをまとめて受け取る条件にはしていない。合成文には反復が含まれ、実際のコードや会話とは分布が異なる。
| 指標 | 今回の定義 |
|---|---|
| Prefill tok/s | サーバーが新規にKV計算したトークン数 ÷ 要求ごとのprefill時間の合計 |
| Decode tok/s | (出力トークン数 − 要求数)÷ 要求ごとのdecode時間の合計 |
| TTFT | クライアントから送信し、最初の非空SSE出力を受け取るまでの秒数。待ち行列・通信を含む |
| 全体出力 tok/s | 全要求の出力トークン合計 ÷ バッチ完了までの実時間。3回分を合算 |
| 最低MemAvailable | 負荷試験中にOSが報告した利用可能メモリの最小値。各台を約1.1秒間隔で観測 |
Prefillとdecodeは、並列処理中の1要求あたりの実効速度である。全体の処理量は「全体出力 tok/s」で見る。要求のphase時間には、ほかの要求のprefillなどを待つ影響も入るため、GPUカーネル単体の速度とは異なる。各phaseのカウンターの意味はvLLMのメトリクス仕様に対応する。
TTFTのp50は50パーセンタイル、p95は遅い側の95パーセンタイルで、いずれもnearest-rank法(昇順に並べた値のうち、要求数×分位を切り上げた順位)で求めた。偶数標本のp50は中央2値のうち下側を採用し、2値を平均する通常の標本中央値とは異なる。図中の「median」もこのp50を指す。今回の標本は条件ごとに3〜24要求と少なく、p95は多くの条件で最大値になる。長期運用のp95を推定した数字ではない。
独立構成:各台2並列と4並列
Prefill・decode・TTFTは両APIの要求を合わせた集計。全体出力は2台合計である。
| 入力 | 各台 / 合計要求数 | Prefill tok/s | Decode tok/s | TTFT p50 / p95 秒 | 全体出力 tok/s | バッチ速度の範囲 tok/s |
|---|---|---|---|---|---|---|
| 4K | 2 / 4 | 1,227.7 | 39.9 | 3.74 / 4.06 | 102.6 | 73.7〜130.4 |
| 4K | 4 / 8 | 1,003.0 | 33.4 | 5.77 / 8.10 | 184.9 | 179.9〜189.4 |
| 32K | 2 / 4 | 2,018.6 | 27.8 | 16.56 / 30.03 | 48.4 | 47.9〜48.6 |
| 32K | 4 / 8 | 1,903.7 | 15.4 | 31.61 / 60.56 | 55.1 | 54.6〜55.8 |
4Kでは、各台2から4並列へ増やすと全体出力速度は102.6から184.9 tok/sへ、約1.80倍になった。その一方でTTFT p50は3.74から5.77秒へ伸び、1要求あたりの実効decodeは39.9から33.4 tok/sへ下がった。
32Kでは各台2並列が全体48.4 tok/s・TTFT p50が16.56秒、各台4並列が55.1 tok/s・31.61秒だった。並列数を倍にしても処理量は約14%増で、応答開始までの待ちは約1.9倍。今回の長めの入力では、各台2並列も使い分ける理由がある。
4K・各台2並列では、3回目に1台目の1要求が約27.8秒かかり、バッチ全体の速度を押し下げた。そのバッチの全体出力速度は約73.7 tok/sで、ほかの2回は約129〜130 tok/sだった。この値も除外せず集計した。該当バッチの高負荷時GPUクロックは両台1,976〜1,982MHzで、以前の507MHz固定は観測しなかった。今回の遅延の原因は確定していない。
2台をまとめるTP=2
| 入力 | 全体要求数 | Prefill tok/s | Decode tok/s | TTFT p50 / p95 秒 | 全体出力 tok/s | バッチ速度の範囲 tok/s |
|---|---|---|---|---|---|---|
| 4K | 1 | 2,590.3 | 32.1 | 1.53 / 1.87 | 29.2 | 18.0〜42.5 |
| 4K | 2 | 2,402.7 | 43.4 | 1.79 / 3.89 | 70.1 | 67.6〜72.1 |
| 4K | 4 | 1,090.2 | 28.9 | 5.88 / 6.41 | 77.8 | 53.6〜102.6 |
| 4K | 8 | 597.4 | 23.0 | 11.14 / 12.86 | 90.2 | 86.8〜94.5 |
| 32K | 1 | 2,832.2 | 55.3 | 11.74 / 11.93 | 24.5 | 24.3〜24.7 |
| 32K | 2 | 2,071.9 | 37.7 | 17.12 / 23.34 | 30.4 | 29.6〜30.7 |
| 32K | 4 | 1,800.3 | 17.1 | 28.85 / 46.96 | 29.4 | 27.1〜34.1 |
| 32K | 8 | 1,687.0 | 9.7 | 52.37 / 94.26 | 35.0 | 31.9〜36.8 |
4Kの総4要求では、全体出力速度が独立構成102.6に対してTP=2は77.8 tok/sで、独立構成が約1.32倍。総8要求では184.9対90.2 tok/sで約2.05倍だった。総8要求のバッチ所要時間も、独立構成の21.6〜22.8秒に対しTP=2は43.4〜47.2秒となった。
32Kでも、同じ総要求数では独立構成が高い処理量を示した。TP=2は全体4並列で29.4 tok/s・TTFT p50が28.85秒、8並列で35.0 tok/s・52.37秒。全体出力速度の独立構成/TP=2比はそれぞれ約1.65倍、1.58倍だった。
TP=2にも遅いバッチがあった。4K・4要求の1回目は約38.2秒で、ほかの2回は約20.0・20.8秒。また4Kの単要求は最初の2回が約12.0秒だったのに対し、3回目は約28.5秒となった。表のdecode 32.1 tok/sは、この遅い回も含めた値である。32Kの単要求55.3 tok/sより低く出たが、「入力を長くすると常に速くなる」という意味ではない。
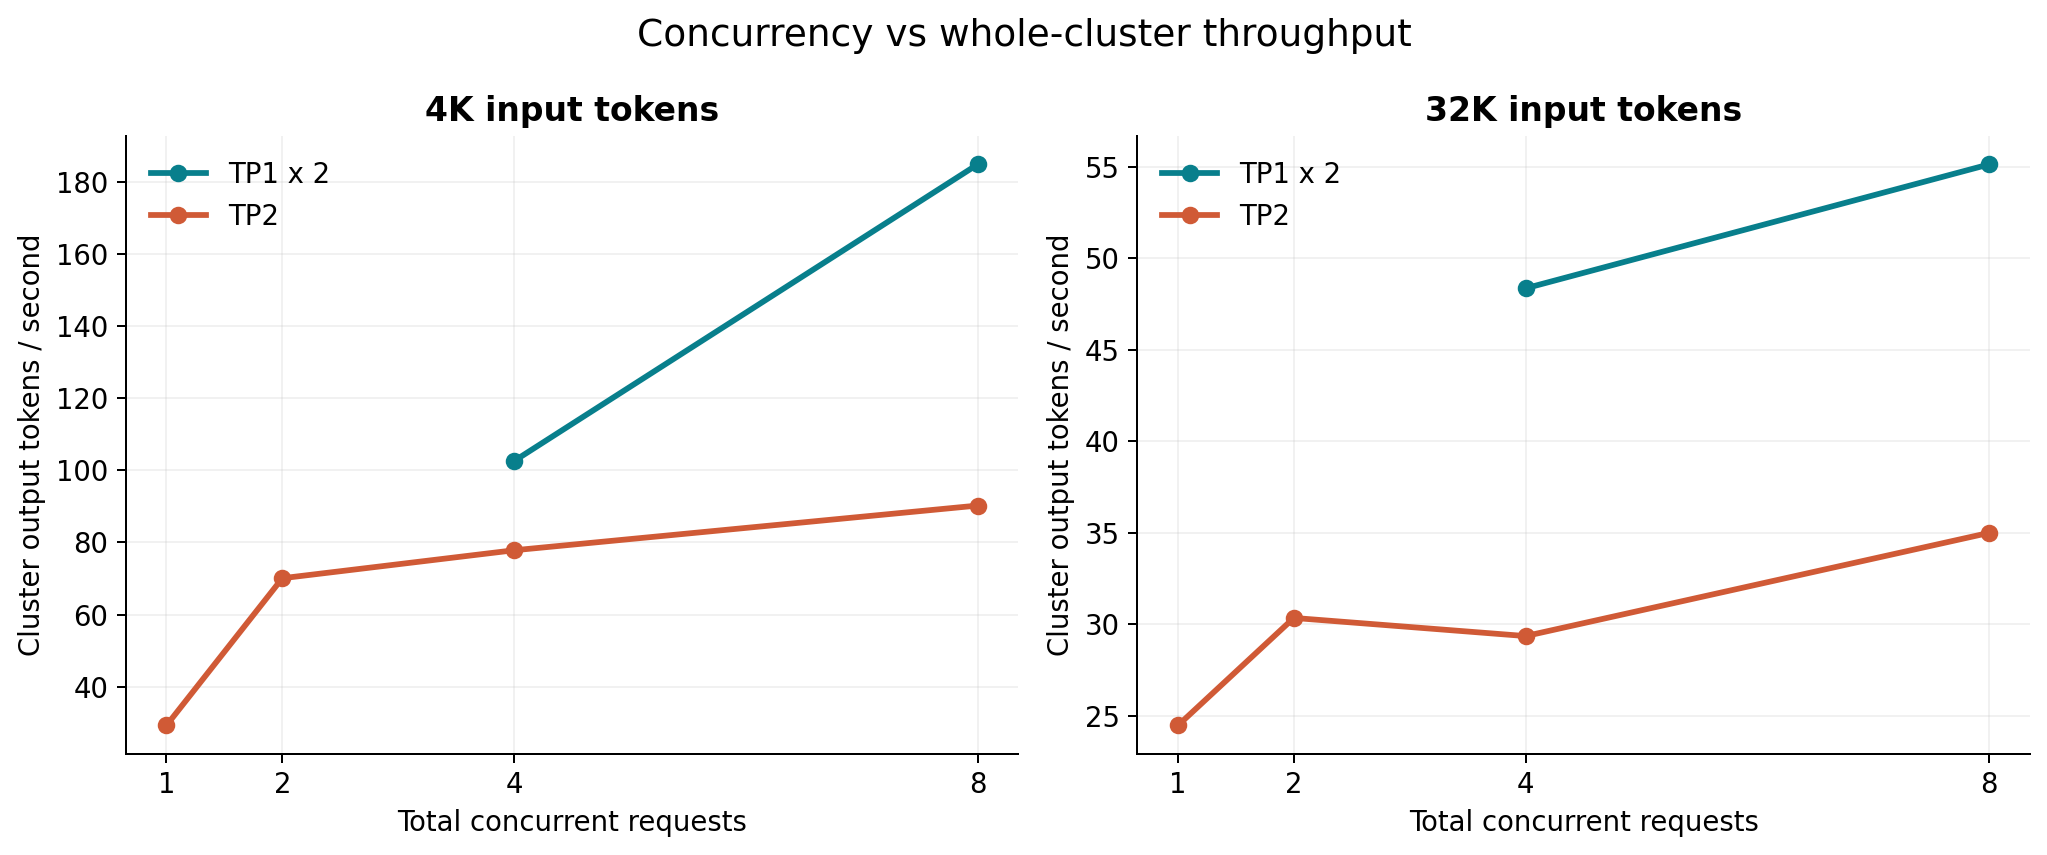
TP=1の点は各台2・4並列、TP=2の点は全体1・2・4・8並列。横軸は、いずれも2台全体に送った同時要求数である。
メモリと、以前見つかった低クロック状態
独立構成では両台とも約17GiBが残った。TP=2では1台目が約2.8GiB、2台目が約6.2GiBで、今回の設定では余裕が小さかった。
| 構成 | 入力 | 合計要求数 | 1台目の最低MemAvailable GiB | 2台目の最低MemAvailable GiB |
|---|---|---|---|---|
| TP=1 × 2台 | 4K | 4 | 16.989 | 16.949 |
| TP=1 × 2台 | 4K | 8 | 17.005 | 16.938 |
| TP=1 × 2台 | 32K | 4 | 17.003 | 16.930 |
| TP=1 × 2台 | 32K | 8 | 17.002 | 16.912 |
| TP=2 | 4K | 1 | 2.828 | 6.209 |
| TP=2 | 4K | 2 | 2.817 | 6.235 |
| TP=2 | 4K | 4 | 2.808 | 6.224 |
| TP=2 | 4K | 8 | 2.765 | 6.213 |
| TP=2 | 32K | 1 | 2.796 | 6.212 |
| TP=2 | 32K | 2 | 2.806 | 6.217 |
| TP=2 | 32K | 4 | 2.783 | 6.182 |
| TP=2 | 32K | 8 | 2.775 | 6.187 |
ここでの「最低メモリ」は試験中に残っていた利用可能メモリを示す。動作に必要な最小RAM容量を求める試験はしていない。GB10の統合メモリ、OS、mmap、確保済みKVプールを含む観測なので、この値を搭載容量から引いて「必要RAM」とはできない。また、1秒程度のサンプリングで捉えられない瞬間的な変化は残る。
今回の追加測定の前には、1台目だけ高負荷でもGPUが507MHzに張り付く状態があった。もう1台は約1,982MHzで動いており、同じ入力でも大きな速度差が出た。本体のシャットダウン・起動と通常のクロック上限再設定後、復旧直後に両台へ同じ入力を送った別の試験では、両台が1,976〜1,982MHzに戻り、各4並列のprefill/decode差は約5%以内になった。
これは再起動後の観測結果であり、電源管理のどの要素が原因だったかまでは特定していない。物理的な電源の抜き差しや放電時間も遠隔では確認していない。温度の高低だけで速度を推測せず、GPU使用率と実クロックを一緒に見る必要があった。
今回の測定162要求とウォームアップ6要求はすべて完走した。すべての条件で、3回とも全要求が同時にrunningとなる状態を観測し、preemptionは0。負荷後のruntime検査は独立構成が各台60項目、TP=2が両rankを対象とした59項目に合格した。高負荷時のGPUクロックは両構成・両台とも1,976〜1,982MHzで、アクティブなclock制限理由は観測しなかった。
TP=2の4K測定序盤には、Linuxのメモリ待ち指標 memory PSI some avg10 が1台目で最大0.78%、2台目で最大8.17%となる標本もあった。OOMやpreemptionは発生しなかったが、通信・TP数・メモリなどの各要因を切り分けた試験ではない。遅い要求の原因をこの指標だけから特定することもできない。
今回の結果をどう使うか
今回の4K/32K・合計4〜8要求では、独立構成が全体出力速度とTTFTの両方で良い値になった。各台2並列なら、各台4並列より応答が始まるまでの待ちを短くできる。各台4並列は、同時に処理したい要求が多い場合の選択になる。特に32Kでは、各台4並列への増加による処理量の伸びが約14%にとどまり、TTFT p50は約1.9倍になった。
TP=2の単要求・32Kではdecode約55.3 tok/sを得た一方、prefillを含む全体出力速度は約24.5 tok/sだった。単独の生成速度と複数要求の処理量を分けて見ると、用途に必要な数字を選びやすい。今回の結果からTP=2の設定全般や、回答品質まで順位を付けることはできない。
検証したのは合成入力4K/32Kと512トークン出力の短い閉じたバッチである。回答品質、日本語の正確さ、長時間のagent処理、連続到着する要求の待ち行列、262Kのcontextを全並列で使う条件は、この結果からは判断できない。
測定値を追えるように、条件別の集計CSV、各バッチのCSV、API別のCSV、個々の要求のCSV、照合結果を含むJSONを添付した。図は比較図SVGと並列数の図SVGも用意した。公開用データには、APIキー、LANアドレス、プロンプトや回答の本文を含めていない。
公開データの列と集計方法(README)も参照できる。性能・メモリ・動作状況の根拠は2026年9月5日の自主実測であり、外部リンクは固定したレシピ・チェックポイントと指標定義の参照先である。
紹介商品の購入先
記事で使用したGX10シリーズ
リンク先はASUS Ascent GX10の1TBモデルです。